AI 时代如何做具身智能
具身智能(Embodied AI)不是一个新词。把它放回今天的具体语境里,值得单独讨论:基础模型(LLM / VLM)的成熟把"机器人理解世界"这件事的成本结构彻底改写了,于是过去几年在实验室里跑不通的事,现在开始有工程团队去推。
这篇文章不是技术综述,是一份工程师视角的判断清单——把模型拆开、把数据拆开、把部署拆开,看哪些环节在 AI 时代变得不一样。
一、先把定义收紧
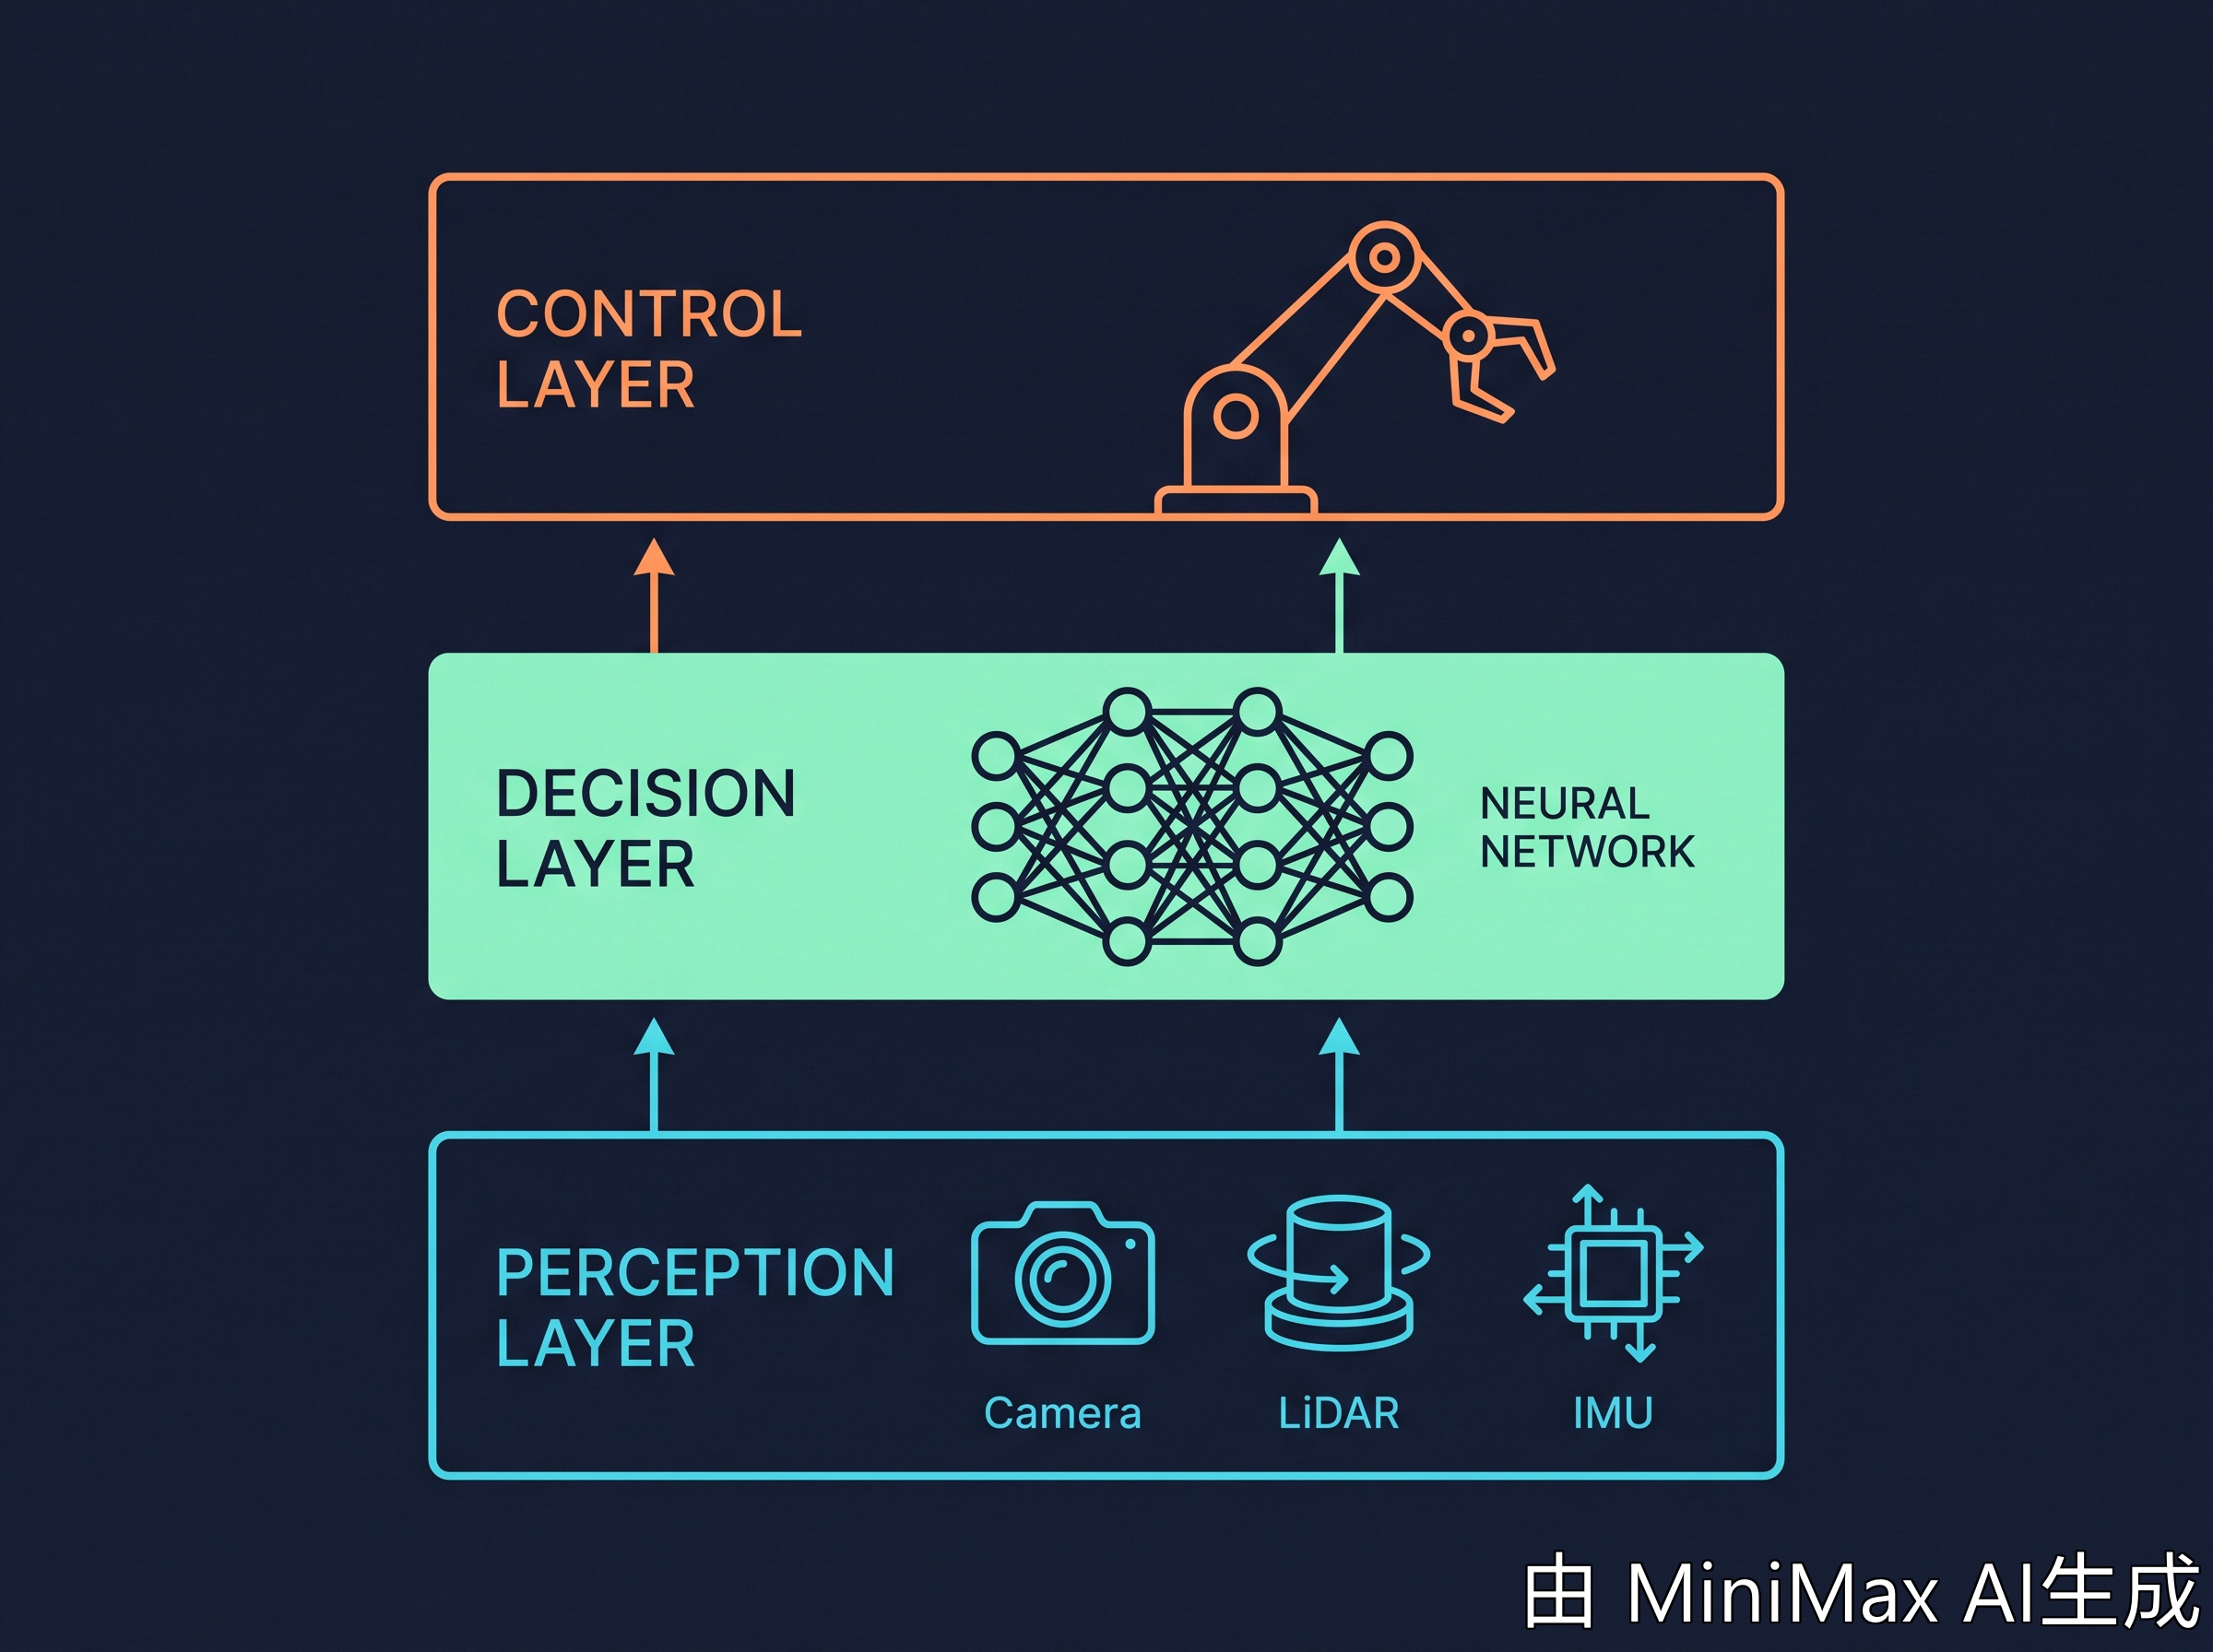
具身智能的常见误解是「把一个大模型塞进机器人里」。但工程上的定义是 agent 必须通过物理动作影响世界,并且其决策结果依赖当前观测。三件事缺一不可:
- 感知:从传感器(相机、LiDAR、IMU、力矩、触觉)拿到世界状态。
- 决策:基于状态 + 任务目标输出动作或动作序列。
- 控制:把高层动作变成低层执行信号(关节电流、车轮转速)。
AI 时代最大的变化是「决策」这一段从手写规则/传统规划,变成了视觉-语言-动作模型(VLA)为主。这不代表控制不重要——控制是落地时最大坑,但它是另一篇文章的事。
二、决策模块:VLA 怎么选
截至 2026 年,主流路径是端到端 VLA(视觉+语言→动作),分三层选型:
- 闭源旗舰(如 OpenVLA-O、Gemini Robotics、Pi 系列):拿来即用,效果上限高,但成本和时延敏感。
- 开源 VLA(如 OpenVLA、RT-2 复刻):能在自建 GPU 上跑得动,需要中等规模团队做 SFT / RLHF。
- 层次化方案:上层 VLM 做任务规划,下层专用模型做原子技能(抓取、避障)。工程上最稳,但模块之间的接口要设计好。
建议:第一次跑通业务前,不要直接用闭源旗舰跑真机——单次推理时延 + token 成本会让你烧不起。先用 simulation 跑通链路,再考虑上闭源。
三、数据:比模型更稀缺的部分
行业里有一句大实话:现在不缺模型,缺数据。数据来源分三层:
- 真机数据:贵、慢、但分布真实。10 小时真机 ≈ 几万到几十万次轨迹。
- 仿真数据(Isaac Sim、MuJoCo、Genesis):便宜、量大,但 Sim2Real gap 是真实存在的。
- 人类视频(Ego4D、Something-Something、YouTube):量最大、最脏,但隐含语义信息最难替代。
健康的数据飞轮比例建议是 1 : 50 : 200(真机 : 仿真 : 人类视频),这是 2025 年头部团队的常见分桶。
四、Sim2Real 的现实
仿真不是万能的。但 2024 年起,domain randomization + 真实场景图片背景融合 + 物理参数 sweep 把 Sim2Real 成功率从 20% 提到了 60-70%。关键的工程实践:
- 域随机化:在仿真里把光照、背景、物理摩擦系数大范围随机化,强制模型学到不变性。
- 外观迁移:用 diffusion model 把仿真渲染变成接近真实的图,作为额外训练信号。
- 物理辨识:对真实机器人的动力学参数(质量、阻尼、传动)做系统辨识,缩小仿真和真实的物理 gap。
五、部署:评估比 demo 重要十倍
任何具身 agent 真正上线前必须有真实场景的回归评估集。建议至少包含:
- 20-50 个常见任务(成功率 ≥ 90% 才算合格)
- 5-10 个边界 case(成功率 0% 也行,但要能 fail safely)
- 3-5 个对抗场景(小孩冲过来、宠物挡路、光照突变)
每个任务跑 50 次以上取中位数。不要相信 demo 视频——单次跑通不算,10 次跑通才算。
六、一个最小可行的项目骨架
如果你今天要立项,我的建议是:
- 选一个单一任务(不要"通用机器人",那是研究院的活)。
- 用开源 VLA + Isaac Sim在 4 周内跑通仿真 demo。
- 在 6 周内把真机数据回灌到训练 pipeline,验证 Sim2Real。
- 在 8 周内完成100 次真机评估,得到可信成功率。
三个月能跑出一个「能稳定完成 1 个任务的机器人」就是合格起点。半年跑通 3-5 个任务就算进入第一梯队。
七、容易踩的坑
- 把 demo 视频当指标。单次跑通 ≠ 稳定 ≠ 可上线。
- 低估数据闭环成本。真实数据采集 + 标注 + 回灌 pipeline 的人力通常比模型训练更多。
- 忽略安全评估。具身 agent 必须能 fail safely——碰撞检测、紧急停止、行为边界。
- 把感知当白盒。相机标定、IMU 噪声、LiDAR 标定这些"无聊的工程"往往比模型重要。
结尾
具身智能不是 2026 年才出现的事。但 AI 时代让它的门槛变得不一样——决策不再是瓶颈,数据和工程闭环才是。如果今天开始做一件事,我会选层次化方案 + Sim2Real + 真实数据飞轮这条路径,而不是上来就 all-in 端到端大模型。
下一篇预告:把"做项目"这件事整理成可复用的工作流模板。